8GB로 시작하는 개인 AI 실험실 / EP00
AI 써서 앱 만들다 결국 Mac Studio를 질렀다
8GB M1 iMac으로 앱을 만들며 겪은 메모리와 저장 공간 문제, Ollama Qwen 실험, Mac Studio를 주문한 이야기를 적었다.
이 글의 내용
AI 써서 앱 만드는 중.
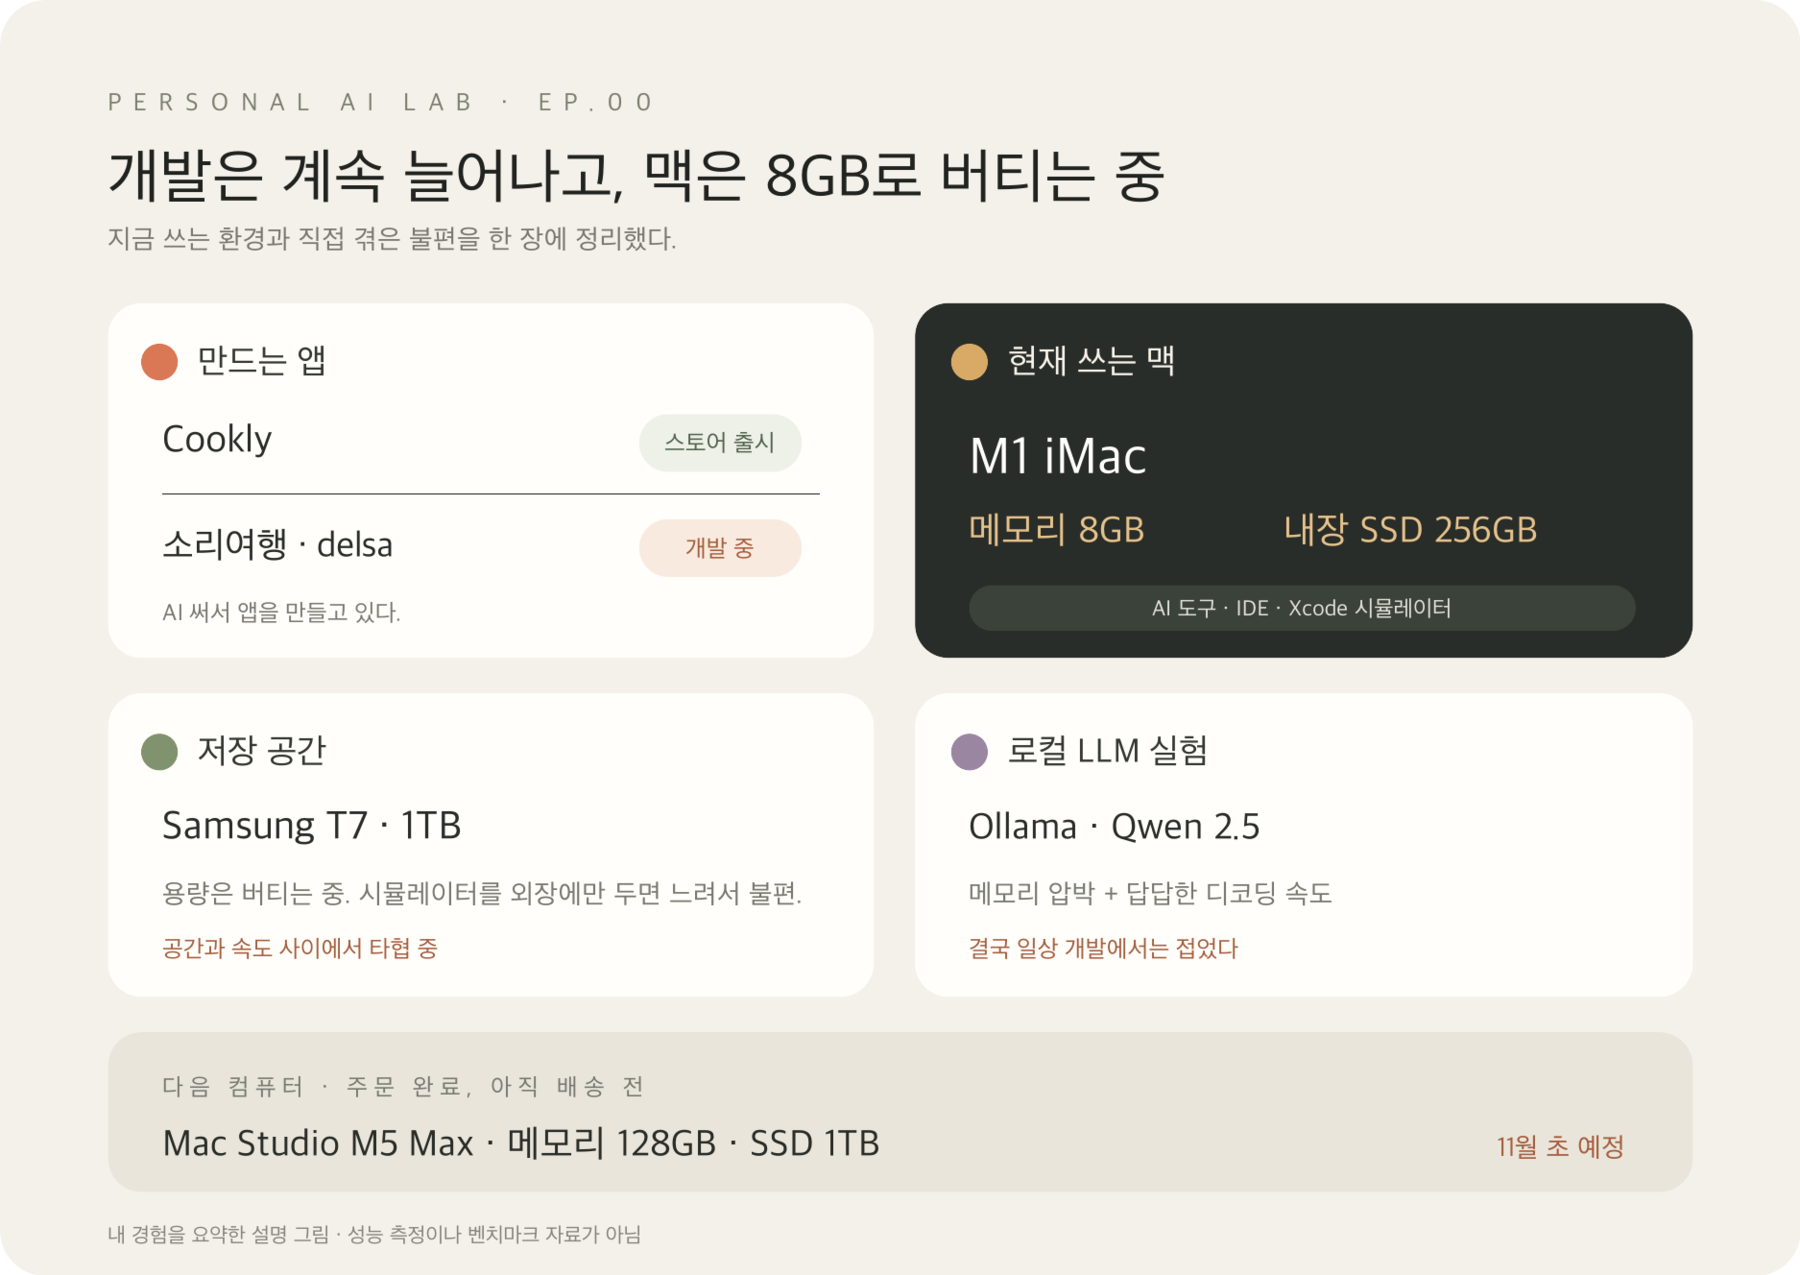
M1 iMac 8GB로 앱 몇 개를 오가다 보면 작업이 자주 끊긴다. 메모리도 빠듯하고, 내부 SSD 256GB도 모자란다. 1TB 외장 SSD로 버티고 있는데 시뮬레이터까지 외장에 두고 쓰자니 느려서 불편하다.
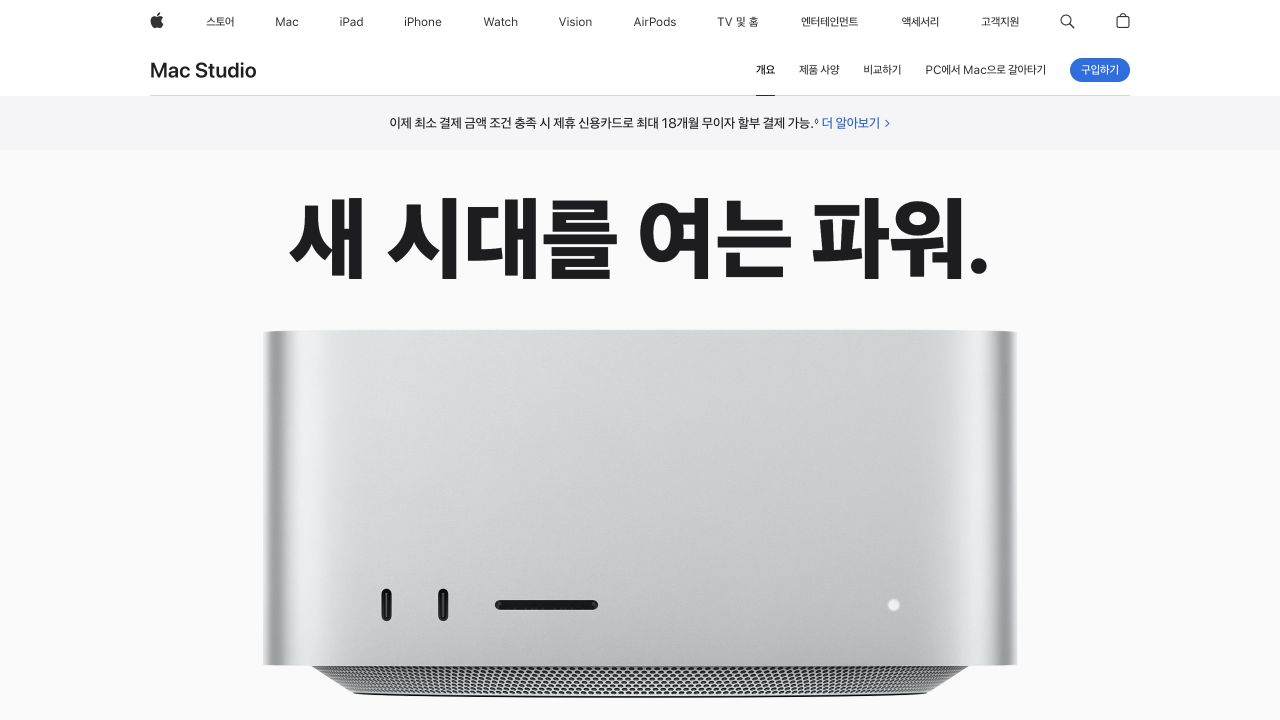
열받아서 Mac Studio M5 Max를 질렀다. 메모리 128GB, SSD 1TB. 11월 초 배송 예정.
잘한 걸까…?
일단 앱을 만들며 겪는 일과 AI 장비 실험을 여기 모아보려 한다.
앱도 만들고, AI 장비도 만져보는 중
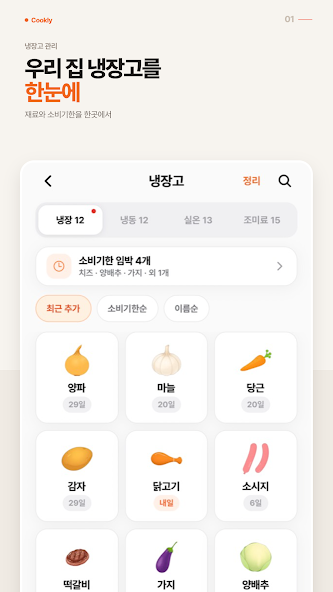
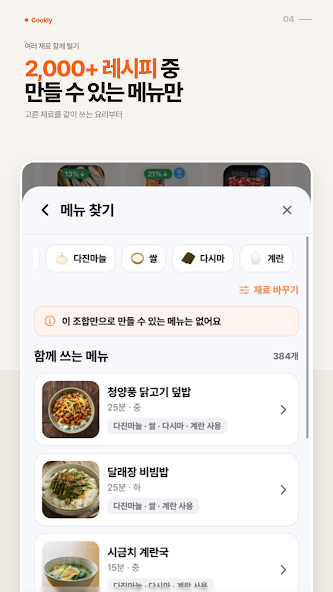
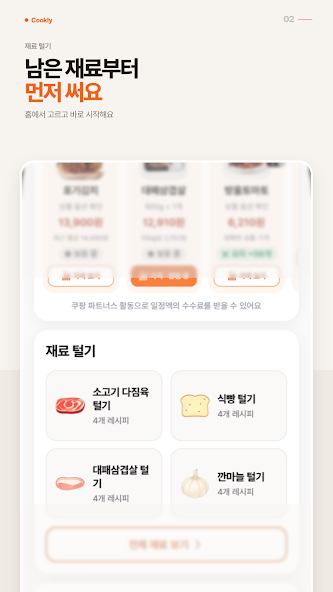
Cookly는 냉장고에 있는 재료로 만들 수 있는 레시피를 추천해주는 앱이다. 이미 App Store와 Google Play에 올라가 있다.
말로만 설명하면 어떤 앱인지 감이 잘 안 올 것 같아, Google Play에 올린 화면도 붙여둔다.
지금은 소리여행과 delsa도 개발 중이다. 이름만 보면 무슨 앱인가 싶을 텐데, 어떤 앱인지와 만들면서 겪은 일은 나중에 따로 적어보려 한다.
여러 앱에 AI 도구를 이것저것 써보는데, 코드만 생각하면 될 줄 알았던 개발이 장비 문제로 자주 새는 중이다. 메모리랑 SSD 공간이 부족하면 작업 흐름도 같이 끊긴다.
AI 도구를 써도 iMac은 바빴다
ChatGPT, Claude, Hermes, Codex를 써서 앱을 만들고 있다. 모델 계산을 클라우드에 맡기는 도구를 써도 IDE, Xcode, 시뮬레이터는 내 맥에서 돌아간다. 이것저것 띄워놓고 프로젝트를 오가면 메모리 압박이 생기고, swap이 늘어나는 것도 봤다. 그러다 작업이 끊길 때가 잦았다.
재시작도 몇 번 겪었지만, swap이 원인이었다고 단정할 자료는 없다. 그때그때 로그를 모아 확인해둔 건 아니어서, 지금 말할 수 있는 건 여러 일이 겹쳐서 작업이 자주 끊겼다는 정도다.
외장 SSD 1TB로 버티는 중
내장 SSD는 256GB. 앱 프로젝트와 개발 도구를 쓰다 보면 여유 공간이 빠듯해진다. 그래서 Samsung T7 1TB 외장 SSD를 붙여 쓰고 있다.
저장 공간은 조금 숨통이 트였지만, 시뮬레이터 같은 개발 환경을 외장 SSD에만 두고 쓰자니 체감 속도가 답답하다. 용량을 아끼려고 외장으로 보내면 작업이 느려지는 게 문제. 아직 속도와 공간 사이에서 타협점을 찾는 중이다.
Ollama에 Qwen도 깔아봤다
Ollama에 남아 있는 모델은 qwen2.5:1.5b-instruct-q4_K_S. 이걸 iMac에서 직접 돌려봤는데 메모리 압박이 있었고, 답이 나오는 속도도 너무 답답했다. 결국 일상적인 개발에 쓰는 건 접었다.
그때 메모리 사용량이나 토큰 생성 속도를 재놓은 건 아니라 정확한 숫자는 없다. 그냥 써보니 내 작업 흐름과는 안 맞았다. Mac Studio가 오면 같은 모델을 다시 켜보고, 이번에는 다른 개발 작업을 같이 띄울 만한지도 확인해보고 싶다.
그래서 어떤 Mac Studio를 샀나
주문한 건 Mac Studio M5 Max다. 2026년 11월 초 배송 예정. 아직 받아보지도 않았으니 지금은 기대만 있는 상태.
가격은 거의 천만 원. 비싸긴 한데, 요즘 메모리랑 GPU 가격을 생각하면 이 구성은 가성비인가 싶기도 하다. 잘 산 건지는 받아서 써봐야 알겠다.
| 항목 | 주문 구성 |
|---|---|
| 칩 · CPU · GPU | M5 Max · 18코어 CPU · 40코어 GPU |
| 통합메모리 | 128GB |
| 메모리 대역폭 | 614GB/s (제조사 사양) |
| 내장 SSD | 1TB |
| 연결 | Thunderbolt 5 · HDMI 2.1 · 10Gb Ethernet |
Apple 공식 사양과 대조한 구성이다. 대역폭은 실측이 아닌 제조사 사양, 배송 시점은 내 주문 안내 기준이다.
Xcode·시뮬레이터와 여러 개발환경을 켜두고 로컬 AI도 써보고 싶어서 128GB를 골랐다. CPU와 GPU가 메모리를 공유하는 구조에 끌렸지만, 용량이 크다고 모든 모델이 빨라지는 건 아니다. 이미지·음성 모델과 파인튜닝도 후보에 넣었다.
메모리는 나중에 늘리기 어려워 먼저 투자했다. 저장공간은 외장으로 늘리면 되니까. 내장 1TB는 macOS·Xcode·작업 프로젝트·캐시·자주 쓰는 모델, T7은 임시 모델·개발 데이터용. 큰 모델·데이터셋·영상 자산과 보관용으로는 T9 추가도 생각 중이다.
어떤 로컬 AI를 돌려볼 생각인가
코딩·추론·긴 입력을 비교할 후보는 Qwen3.8-Flash-Next와 DeepSeek-V4-Flash-0731. 일상 작업은 Qwen3.8-27B 같은 20~30B급부터 써보고, 큰 모델은 필요할 때만 불러오려 한다. 버전·양자화 파일·메모리 사용량은 설치할 때 다시 확인할 생각이다.
실행 도구는 Apple Silicon용 MLX/mlx-lm, 범용 llama.cpp, MLX 서버인 oMLX를 비교하려 한다. ds4(DwarfStar)와 Slipstream의 SSD 가중치 스트리밍도 궁금하다. oMLX의 SSD KV 캐시와는 다른 방식. 되는 모델·파일 형식은 따로 확인해야 하고, 내 맥에서 비교한 결과는 아직 없다.
거대한 LLM 하나보다 개인 AI 시스템
대화·기억은 Hermes, Paseo로 iPhone에서 요청하고 상태 확인. JevMLX로 작업 분류·관련성 판단·검증을 시험하고, 부족한 로컬 작업은 OpenCode Go, 어려운 코딩은 Codex로 넘기려 한다. QwenPaw와 비교하며 Hermes를 우선 검토 중이다.
iMac의 작은 PoC에서는 Ollama Qwen 1.5B 결과를 검증하고, 통제된 시험에서 실제 공급자를 호출해 OpenCode Go → Codex CLI로 넘기는 흐름을 확인했다. QwenPaw·Paseo의 iPhone 연결도 시험했다. 범용 시스템이 완성된 건 아니고, JevMLX 적용과 Codex ACP 직접 위임은 미확인이다.
Cookly 광고 이미지·영상은 ComfyUI로, KnitLens는 도안·완성품 데이터로 특화 모델과 이미지 품질 개선을 시험하고 싶다. 음성 인식·TTS·음악 생성, 실험 로그에서 Hermes가 블로그 초안을 만드는 일도 후보.
도착하면 가장 먼저 해볼 실험
도착하면 같은 모델로 로딩 시간·첫 응답·입력 처리·디코딩 속도·메모리 최고 사용량·swap을 재보려 한다. 긴 입력·도구 호출·동시 세션·모델 전환도 써보고, SSD 스트리밍은 내장과 외장을 비교할 생각이다.
아직 모르는 것
이 글은 내 iMac에서 겪은 일에 대한 기록이다. 메모리와 swap의 시간별 변화, 모델별 토큰 생성 속도, 재시작 원인을 확인한 건 아니다. 그래서 특정 장비나 도구가 작업 중단을 일으켰다고 단정하지 않는다.
처음에는 128GB 메모리에 얼마나 큰 LLM을 올릴 수 있을지만 궁금했다.
그런데 이것저것 알아보다 보니 생각이 조금 달라졌다. 거대한 모델 하나를 돌리는 것보다, 적당한 크기의 언어 모델에 이미지·음성·영상 모델을 조합하고, Hermes 같은 에이전트가 필요할 때 알아서 활용하도록 만드는 편이 더 재미있을 것 같다.
물론 아직은 계획뿐이다. 모든 모델을 동시에 올려둘 생각은 없지만, 개발환경과 필요한 모델을 함께 띄울 수 있을지부터 확인해야 한다. SSD에서 모델을 불러오는 방식이 얼마나 실용적인지, 로컬과 클라우드를 조합하면 효율이 나아지는지도 직접 써봐야 안다.
일단 Mac Studio가 도착해야 한다.
배송 예정일까지 아직 시간이 남았다. 그동안은 8GB iMac으로 버티면서, 무엇을 먼저 실험할지 정리해보려고 한다.